Sequenziertiefe: Warum mehr DNA-Daten nicht jede Frage lösen
Ein Bakterium erkennen ist nicht dasselbe wie sein Genom rekonstruieren. Ein kontrollierter Benchmark zeigt, welche Rückfragen bei Sequenziertiefe wirklich helfen.
Methoden verständlich · Sequenziertiefe
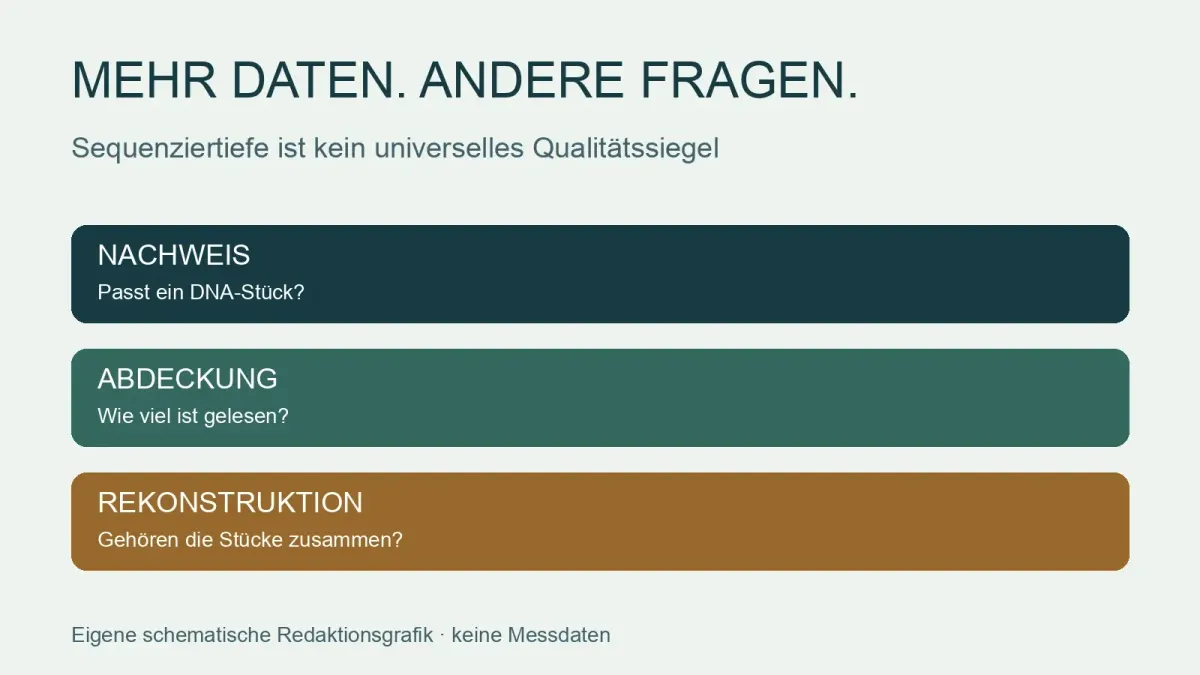
Mehr Sequenzdaten können helfen. Sie beantworten aber nicht automatisch die schwierigere Frage. Ein neuer Laborbenchmark zeigt, warum ein Bakterium nachzuweisen, seinen Stamm zu erkennen und sein Genom zusammenzubauen drei verschiedene Aufgaben sind.
Wenn in einem Mikrobiombericht „Shotgun“ steht, klingt das nach einer besonders vollständigen Bestandsaufnahme. Doch hinter derselben Methodenbezeichnung können unterschiedliche Datenmengen und Auswertungswege stehen. Die entscheidende Rückfrage lautet deshalb nicht nur: Wie tief wurde sequenziert? Sondern: Welche Aussage sollte diese Tiefe überhaupt ermöglichen? Die Arbeit von Treichel und Kollegen in Nature Microbiology liefert dafür einen ungewöhnlich kontrollierten Prüfstand: Das Team kannte die eingesetzte bakterielle DNA und konnte Ergebnisse mit diesem bekannten Ausgangspunkt vergleichen. [1]
Die Evidenz in einer Minute
- Design: Methodenbenchmark mit 13 definierten bakteriellen DNA-Mischungen, darunter drei Hauptmischungen und zehn Varianten. Keine Behandlungsstudie mit Patientinnen oder Patienten.
- Vergleich: Sequenziertiefen von 0,1 bis 50 Gigabasen, Referenzabgleich versus Genomrekonstruktion sowie verschiedene Labor- und Bioinformatikverfahren.
- Haupterkenntnis: Bei bekannten Referenzgenomen kann wenig Datenmaterial für taxonomische Profile genügen. Für umfassende Genabdeckung und neue Genomrekonstruktionen gelten andere Anforderungen.
- Grenze: Weder eine allgemeine Mindesttiefe für jeden Stuhltest noch ein besseres Behandlungsergebnis wurde nachgewiesen.
Was wurde tatsächlich verglichen?
Die Forschenden mischten DNA aus kultivierten Darmbakterien menschlichen und murinen Ursprungs. Zwei Hauptmischungen enthielten jeweils 70 Stämme: einmal mit gleichmäßiger, einmal mit stark ungleichmäßiger Verteilung. Eine weitere Mischung enthielt 24 Stämme in ungleichen Anteilen. Zehn zusätzliche Varianten dieser 24er-Mischung dienten einem besonderen Rekonstruktionsvergleich. „13 Mischungen“ bedeutet also nicht 13 unabhängige menschliche Stuhlproben und erst recht nicht 13 klinische Studien. [1]
Dieser Aufbau hat einen Vorteil: Das Soll ist bekannt. Bei einer echten Stuhlprobe weiß man vor der Messung nicht vollständig, welche Genome enthalten sind. Im Benchmark lässt sich dagegen fragen, ob ein Verfahren vorhandene Stämme übersieht oder scheinbare Genome erzeugt, die so nicht eingesetzt wurden. Der Preis dieser Kontrolle ist eine begrenzte Übertragbarkeit. Die Mischungen enthalten nur Bakterien und bilden die Vielfalt eines natürlichen Darmökosystems nicht vollständig ab.
Ein Teil der Mischungen wurde zusätzlich mit Hintergrund-DNA aus dem Darminhalt keimfreier Mäuse versetzt. Außerdem verglich das Team Bibliotheksvorbereitung in zwei Einrichtungen. Das ist wichtig für die Einordnung: Untersucht wurde nicht nur eine Zahl auf dem Sequenziergerät, sondern eine Messkette. Der Aufbau trennt allerdings nicht den isolierten Effekt jedes einzelnen Laborparameters. Er erlaubt daher keine pauschale Rangliste aller Labore oder Kits.
Nachweisen ist nicht vollständig lesen
Bei direktem Abgleich mit den bekannten Referenzgenomen wurden schon bei 0,1 Gigabasen Sequenzabschnitte aller eingesetzten Stämme gefunden. Gleichzeitig waren bei dieser Tiefe die meisten Genome nur zu einem kleinen Teil abgedeckt. Der Nachweis einzelner passender Abschnitte ist also etwas anderes als ein weitgehend vollständig gelesenes Genom. Das lässt sich wie ein Buch verstehen: Ein paar erkennbare Sätze können den Titel verraten, ohne dass man sämtliche Kapitel besitzt. Der Vergleich ist nur eine Erklärung, keine zusätzliche Messung. [1]
Auch die Verteilung innerhalb der Probe zählt. Bei ungleichen Mischungen sind seltene Genome schwerer umfassend abzudecken als häufige. In der komplexen 70er-Mischung blieben einzelne sehr selten eingesetzte Genome selbst bei 50 Gigabasen nur schwach abgedeckt. „Mehr Daten“ hilft somit nicht für jedes Mitglied gleich stark. Eine hohe Gesamtdatenmenge ist keine Garantie dafür, dass jeder seltene Stamm ausreichend repräsentiert ist.
Vier Fragen, vier verschiedene Maßstäbe
Diese Evidenzmatrix ordnet die Ergebnisse ein. Die Zahlen sind keine Kaufempfehlungen und keine individuellen Grenzwerte.
| Analyseziel | Beobachtung im Benchmark | Was daraus nicht folgt |
|---|---|---|
| Bekannte Stämme erkennen | Referenzbasierte Erkennung mit geringer Tiefe möglich; Abschnitte aller Stämme bereits bei 0,1 Gb gefunden. | Kein Beleg für vollständige Genome oder gleichermaßen gute Erkennung ohne passende Referenzen. |
| Genome weitgehend abdecken | Abdeckung steigt mit Tiefe; Menge und Verteilung der DNA bleiben entscheidend. | Keine universelle Mindesttiefe für jede natürliche Probe. |
| Stoffwechselwege erfassen | Im Ergebnisteil werden ungefähr 5 Gb für Analysen auf Wegeebene zusammengefasst. | Gene belegen weder tatsächliche Aktivität noch eine Wirkung im Menschen. |
| Genome neu rekonstruieren | Auch bei 10 Gb können als hochwertig eingestufte MAGs aus mehreren Ausgangsgenomen zusammengesetzt sein. | Ein Qualitätslabel beweist keine korrekte Stammrekonstruktion. |
Quelle: [1], Results und Discussion. Gb = Gigabasen sequenzierter DNA. Qualitative Einordnung verschiedener Analyseziele; keine gemeinsame Leistungsskala.
Die Referenzdatenbank verändert die Antwort
Der direkte Abgleich hatte im Versuch einen idealen Ausgangspunkt: Die richtigen Referenzgenome waren verfügbar. Das darf man nicht mit jedem üblichen Datenbankprofil gleichsetzen. Mit dem verbreiteten Werkzeug MetaPhlAn4 wurden weniger Arten erkannt; in den getesteten Mischungen erreichte dieses Verfahren nicht dieselbe Unterscheidung nah verwandter Stämme wie der gezielte Referenzabgleich. Ein Vergleich zweier Testberichte müsste deshalb neben der Datenmenge auch Datenbank, Software und konkrete Validierungsaufgabe berücksichtigen. [1]
„Stammebene“ ist damit kein einheitliches Gütesiegel. Es kann bedeuten, vorhandene Sequenzen passenden bekannten Referenzen zuzuordnen. Es kann aber auch bedeuten, aus vielen kurzen Stücken ohne vorgegebenes vollständiges Zielgenom ein neues Genom zusammenzusetzen. Diese zweite Aufgabe ist wesentlich anders. Wer beide unter einer einzigen Auflösungsangabe zusammenfasst, verdeckt genau die Unterscheidung, die dieser Benchmark sichtbar macht.
23 hochwertige Genome – aber nicht 23 eindeutige Ursprünge
Ein konkretes Ergebnis aus Mock-even-70 bei 10 Gb: Von 23 als hochwertig eingestuften metagenomisch rekonstruierten Genomen wurden zehn mehreren Referenzgenomen zugeordnet.
ein Referenzgenom10 / 23
mehrere Referenzgenome
MAG steht für ein aus metagenomischen Daten zusammengesetztes Genom. „Hochwertig“ bedeutete hier mehr als 90 Prozent geschätzte Vollständigkeit und weniger als fünf Prozent geschätzte Kontamination nach den eingesetzten Standardkriterien. Trotzdem konnten Sequenzen verschiedener Ausgangsgenome darin stecken. Die Zahl der Referenzzuordnungen wurde mit einer im Artikel definierten Abdeckungsschwelle ermittelt. Auch die 13 übrigen MAGs sind deshalb nicht als vollkommen fehlerfreie Gesamtgenome bewiesen. [1]
Warum tiefer nicht automatisch eindeutiger wird
Bei der Rekonstruktion werden zuerst längere Sequenzstücke zusammengesetzt und anschließend zu mutmaßlichen Genomen gruppiert. Im Versuch konnten sowohl das Zusammensetzen als auch das Gruppieren zu Mischgebilden beitragen. Bei hoher Tiefe entstanden teils sogar mehr rekonstruierte Genome, als ursprüngliche Stämme enthalten waren, während andere Stämme nicht repräsentiert wurden. Ein höherer Zähler im Ergebniskatalog war damit nicht einfach mehr korrekt erfasste Vielfalt. [1]
Andere Auswertungswege, die gemeinsame Information mehrerer Mischungen nutzten, ein anderer Assembler und lange Sequenzlesungen reduzierten das Problem teilweise. Keiner der getesteten Ansätze beseitigte es vollständig. Das ist kein Urteil, dass Genomrekonstruktionen nutzlos seien. Es bedeutet, dass Vollständigkeits- und Kontaminationskennzahlen nicht alle relevanten Fehler abdecken und dass Rekonstruktionsziele eigene Kontrollen brauchen.
Funktionelle Gene sind noch keine gemessene Funktion
Die Studie verglich außerdem vorhergesagte Proteinsequenzen und die Vollständigkeit annotierter Stoffwechselwege. Diese Ebenen dürfen nicht ineinander übersetzt werden. Ein grobes Wegeprofil kann ähnlich aussehen, obwohl zahlreiche einzelne Proteinsequenzen fehlen. Und ein gefundenes Gen ist noch keine Messung, wie stark sein Produkt unter realen Bedingungen arbeitet. Aus diesen Analysen lässt sich deshalb weder ein tatsächlicher Stoffwechselumsatz noch ein gesundheitlicher Nutzen ableiten. Gemessen wurde die technische Wiederfindung genetischer Information. [1]
Bei den Tiefenangaben lohnt sich genaues Lesen: Der Abstract nennt zwei Gigabasen für verlässliche Einblicke auf Wegeebene. Der Ergebnisteil fasst dagegen ungefähr fünf Gigabasen für Wegeanalysen über die Mischungen hinweg zusammen; die Verläufe unterscheiden sich nach Mischung und Vollständigkeitskriterium. Wir behandeln diese Formulierungen nicht als austauschbare allgemeine Mindestwerte. Für den vollständigen Proteinkatalog lagen die Anforderungen höher und hingen ebenfalls von der Komplexität ab.
Drei Rückfragen für einen verständlichen Laborbericht
Öffnen Sie die Erläuterungen. Die Fragen dienen dem Methodenverständnis, nicht der Selbstdiagnose.
1. Welches Analyseziel wurde geprüft?
Fragen Sie nach der Trennung von Erkennung, relativer Häufigkeit, Genabdeckung und neuer Genomrekonstruktion. Eine überzeugende Prüfung für ein Ziel belegt nicht automatisch die anderen Ziele. Genau diese Trennung wird im Benchmark an bekanntem Ausgangsmaterial möglich.
2. Worauf bezieht sich die angegebene Datenmenge?
Fragen Sie nach Einheit, Qualitätsfilterung und Umgang mit Hintergrund-DNA. Die Studie dokumentiert Zielmengen gepaarter Lesungen und nachfolgende Verarbeitung. Eine reine Gesamtzahl ohne Beschreibung des Verfahrens lässt sich deshalb nur eingeschränkt mit ihren Ergebnissen vergleichen.
3. Welche Referenzen und Kontrollen wurden eingesetzt?
Fragen Sie nach Datenbank, Version und einem Benchmark mit bekanntem Soll. Der Referenzabgleich war hier ein Idealfall. Unbekannte oder unzureichend repräsentierte Genome können sich anders verhalten. Eine Antwort auf diese Methodenfrage ist noch kein Nachweis, dass ein Test eine Behandlung verbessert.
Was für die Praxis übrig bleibt
Die stärkste Aussage lautet nicht „jeder braucht tiefe Sequenzierung“. Sie lautet: Die Datenmenge muss zum Ziel passen. Für große Studien mit gut beschriebenen Gemeinschaften und passenden Referenzen kann flache Sequenzierung taxonomische Information liefern. Für neue Stammrekonstruktionen und fein aufgelöste funktionelle Analysen sind die Hürden höher. Auch mehr Daten ersetzen keine geeignete Auswertung und keine Prüfung auf künstlich zusammengesetzte Genome.
Für Leserinnen und Leser entsteht daraus ein konkreter Gewinn: Sie können eine technische Aussage im Bericht genauer hinterfragen, ohne aus einer Zahl ein Gesundheitsurteil zu machen. Die Studie untersuchte keine Therapie, keinen Symptomverlauf und keine klinische Entscheidung. Ein Anbieter kann sich deshalb mit diesem Benchmark nicht allein einen besseren Patientennutzen bescheinigen lassen. Ebenso wäre es falsch, aus den beobachteten Rekonstruktionsfehlern jeden taxonomischen Nachweis für unbrauchbar zu erklären.